Webclient (v18) hängt friert ein - weil 3CXPhoneSystem Ram frisst und 100% CPU hat

c_cloud

Bronze Partner
Advanced Certified
Mitglied seit
14. März 2020
Beiträge
37
Hallo,

ist jmd schonmal über ein ähnliches Problem gestolpert:

Aus unerklärlichen Gründen flippt auf einmal der Prozess "3CXPhoneSystem" aus und läuft mit über 100% Last, Webclient wird blockiert, man kann nichts klicken, oder wählen / Anruf annehmen. In der 3CX GUI bei Dienste zieht sich der SIP Server Dienst mehr und mehr RAM rein.... Erst nach einem Neustart des Dienstes läuft die Anlage wieder normal.... Wenn man gar nichts macht, regelt sich das in ca 5min RAM und Swap steigen aber immer weiter und werden nicht freigegeben. Es endet dann irgendwann in einem OOM und der Dienst wird vom OOM gekillt.

Die 3CX lief über 140 Tage ohne Problem - keine Änderungen an irgendwas. Hat jetzt 8Kerne 16GB Ram und 8GB Swap bekommen ( Lief vorher mit 4C 8GB und 2GB Swap, ohne diese Probleme ). Ist eine V18 Update 9 build 31, also aktueller / neuster v18 Stand.

Danke
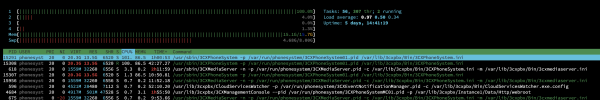
 

Anhänge

  • Bildschirmfoto 2024-09-23 um 13.30.11.png
    Bildschirmfoto 2024-09-23 um 13.30.11.png
    241,1 KB · Aufrufe: 8
  • Bildschirmfoto 2024-09-24 um 09.09.36.png
    Bildschirmfoto 2024-09-24 um 09.09.36.png
    22,6 KB · Aufrufe: 8
Hat die Disk Probleme? IO Latenz zu hoch oder Dateisystemfehler, so dass z.B. nicht mehr in die DB geschrieben werden kann usw.?
 
Denke nicht, ist ne VM auf nem CEPH-Cluster... kein iowait. Alle anderen VMs auch unauffällig was IO angeht.
 
Normal ist das nicht, aber hatten wir schon. Laut meiner Erfahrung: Hardware, speziell hier die Disk. Wenn z.B. Backups oder Snapshots auf dem Disk System (auch von anderen VM) kurz hohe Last erzeugt haben. Oder das Storage Netzwerk kurz voll ausgelastet war (Leitung zu, Unterbrechung). Oder sich diese VM mit einer der anderen VM Kerne teilt und die andere VM zeitweilig richtig Leistung zieht (z.B. ein System mit OCR bei einem Kunden). Wenn es ein Problem des Timer wäre (falsche Zeit, kein ntp installiert, Zeit des HV wird zur VM durchgereicht) dann äußert sich das i.d.R. etwas anders.

Lösung bei diesem Kunden: die 3CX auf separater Hardware betreiben (in diesem Fall sogar nativ glaub ich).
 
Interessanter Ideen und danke für die Erfahrungen. Ich kann das aber eher ausschließen. Die 3CX laufen bei uns im Rechenzentrum. Cluster sind mehr als üppig dimensioniert. Zu den Zeitpunkten, liefen keine Snapshots oder Backups, keine andere VM hat Leistung gezogen. Sollte irgendwas ausfallen ( Netzwerk, Ports down / up usw. ) kriegen wir das mit. Es lässt sich einfach nicht wirklich erklären. Zumal es seit Monaten ohne Probleme lief, bei zT deutlich mehr Last auf dem Cluster.
 
Man kann sich wie sonst üblich die Logs der 3CX anschauen. Da sieht man evtl. das Problem was der Dienst selber hat. Aber so haben wir bei solchen Ungereimtheiten noch nie die zu Grunde liegende Ursache gefunden, nur die Auswirkungen.
 
Nur so zur Info, wir haben die VM eben mal auf lokalen NVMe Storage verschoben - das gleiche Problem tritt weiterhin auf.
 
Ist noch sonstige Software auf der 3CX installiert? Greift sonst noch etwas auf die 3CX zu? Gibt es CFD Apps?
 
Es ist das VoIP Tools Relay installiert. Der Dienst wurde aber vorübergehend gestoppt - um ihn als Problem auszuschließen. Das Relay war auch schon vor 150 Tagen installiert und lief.
 
Es ist das VoIP Tools Relay installiert. Der Dienst wurde aber vorübergehend gestoppt - um ihn als Problem auszuschließen. Das Relay war auch schon vor 150 Tagen installiert und lief.
Ist das aktuell? Außerdem: deinstalliert ist schnell ....

Läuft da irgend etwas massiv an Port 5060 auf? Oder insgesamt an Verbindungen (Tunnel Ports)? Sonst mal die SIP Ports von außen bis auf die IP der Trunk Provider sperren.
 
Zuletzt bearbeitet:
Ja die Neuste Version 18.9.55 - damit wurden die Probleme noch größer... stündliche Hänger der ganzen 3CX, zT konnte der SIP Server Dienst nach Neustart wieder RAM ohne Ende fressen. VoipTools Relay Dienst dann beendet. Problem treten dann alle paar Stunden auf. Deinstallierte ist ja nur das Verzeichnis löschen, wüsste aber nicht wo der Unterschied zu Dienst Stop und disablen ist. Nach dem Dienstneustart läuft es wieder für ein paar Std. massiv auf 5060 ( sowas wie ein DDoS ) würde ja dann weiter Probleme verursachen.
 
Mal nach den aktuell hergestellten Netzwerkverbindungen geschaut?
 
Liste bitte, wieviele Clients insgesamt und was für Clients (Webclient / Desktop App / SBC / Telefone hinter SBC / Smartphone Clients / sonst. Endgeräte hinter SBC) angebunden sind und schau bitte, ob da irgend etwas per direct STUN (auch mit den letzten v18 schon ein deprecated Feature) angebunden ist.

Zudem s.o.: Wurden die SIP Ports der 3CX per Firewall auf die Verbindungen zu den SIP Trunk Providern eingegrenzt? Ohne direct STUN sollte außer den SIP Trunks keine sonstige SIP Port Weiterleitung zur 3CX nötig sein (und ehrlich: auch die grundsätzlich sowieso und überhaupt nicht, es geht komplett ohne).

Kann das Aufkommen von einem SBC oder einem Gerät dahinter kommen?

Wenn die 3CX in eurem eigenen RZ für vmtl. externe Kunden läuft (sonst bitte erklären): Gibt es überhaupt eine Firewall vor der 3CX? Hat die 3CX ihr eigenes heilwegs abgeschottetes Netz dort? Läuft da irgend ein Proxy davor oder hat die eine eigene IP(v4)? Werden eigene Zertifikate für Secure SIP verwendet (und welche überhaupt)?

Alles nicht normal, schon gar nicht 'spontan'. Es kommen immer mehr Fragen auf. So langsam wird es interessant.
 
Anders gefragt: jetzt, um diese Zeit, evtl. ohne Telefonieaufkommen, mit nur wenig Endgeräten und wenig angemeldeten Endgeräten - Tritt das Problem noch so vehement auf? Oder ist die 3CX rund um die Uhr im Einsatz? Da fehlen so einige Informationen rund um die Größenordnung der 3CX, der Endgeräte und das Nutzungsverhalten. Angefangen hat alles mit dem Webclient.
 
Also, jetzt ist Schicht im Schacht. Die User nutzen die zu den üblichen Bürozeiten, sagen wir ab ca. 8Uhr bis 18 oder 19 Uhr.
Ca 180 Nebenstellen aktiv aktuell, kein STUN. Alle Deskphones oder DECT Geräte sind über SBC angebunden und waren es schon immer. Ansonsten Webclients, Desktop App, und Smartphones dabei.

Kein Proxy davor, war auch noch nie.... jede Anlage hat ihre eigene IPv4 und man mag es kaum glauben auch v6. Die Anlage bzw. der SIP-Dienst auch noch nie nachts gecrashed bzw. mit über 100% CPU - immer nur zu "Nutzungszeiten".

Nachtrag: es gibt auch kein packetloss während das "Problem" auftritt. Admin GUI lässt sich aufrufen, den SIP Dienst Neustarten und es laufen alle Gespräche wieder....

Nachtrag2: es fing nicht mit dem Webclient an... kein Client konnte telefonieren, bzw. von extern wurde auch kein Ruf vermittelt / signalisiert.
 
Zuletzt bearbeitet:
Sieht aus, als wäre eine Snom M900 Auslöser des Problems... hinter nem SBC, Status LED war orange blinkend, die hatte weder ne MAC noch IP Adresse.... zumindest nix auf dem Switch sichtbar. Seiddem die entfernt wurde ist Ruhe.
 
Das ergibt für mich keinen Sinn. Ich wüsste nicht, wie eine solche DECT Basis per SBC eine 3CX fluten können sollte. Ich hatte zwei ganz andere Dinge in Verdacht die wir auch schon mehrfach in kleinerem Rahmen beobachtet haben.

Aber gut wenn euer Problem gelöst ist.
 

Statistik des Forums

Themen
44.724
Beiträge
233.586
Mitglieder
78.479
Neuestes Mitglied
200
