


Wie Sie Ihre Agenten der richtigen OpenAI-Nutzungsstufe zuordnen.
Sobald Sie einen KI-Agenten eingerichtet haben, besteht eine seiner Aufgaben typischerweise darin, die Absicht des Anrufers zu verstehen und den Anruf an die passende Nebenstelle weiterzuleiten. Wichtig: Ihr KI-Agent muss Zugriff auf den OpenAI-Dienst haben und darf nicht durch Ratenbegrenzungen eingeschränkt sein. Erreicht Ihr KI-Agent eine Ratenbegrenzung, erhält der Anrufer keine Antwort, und der Anruf wird abgebrochen. Der Anruf wird nicht weitergeleitet, und der Anrufer legt auf. Um Ratenbegrenzungen zu vermeiden, haben wir einige Richtlinien für Sie zusammengestellt.
Dieser Blogbeitrag ist recht lang! Zusammenfassend behandeln wir folgende Themen:
- Typische Logmeldungen bei Erreichen von Ratenlimits
- Mathematische Grundlagen zur Schätzung des Tokenverbrauchs
- Die technische Komplexität eines Aufrufs und deren Einfluss auf den Tokenverbrauch
- Der Einfluss von Wissensquellen auf den Tokenverbrauch
- Übersetzung von Ratenlimits in simultane KI-Agentenaufrufe
- Nutzung von OpenAI zum Verständnis und zur Anpassung Ihrer Ratenlimits
- OpenAI-Konten, die mindestens 100 US-Dollar zahlen, werden in der Regel direkt in die Stufe 3 hochgestuft.
Protokollmeldungen bei Erreichen der Ratenbegrenzungen
Wenn Sie das OpenAI-Ratenlimit erreichen, können Sie dies in der Datei 3CXAI.log sehen; hier ist ein Beispiel:
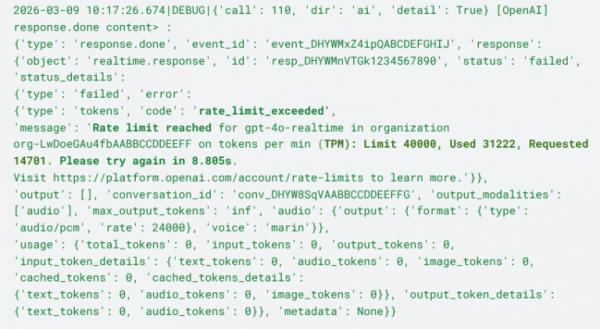
…was deutlich zeigt, dass
- Das Limit für die Token-pro-Minute-Rate (TPM) wurde erreicht.
- Innerhalb der nächsten 8,805 Sekunden können keine Anfragen bearbeitet werden.
Wir können das Problem auch mathematisch betrachten:
- Das aktuelle Limit für dieses Konto beträgt 40.000 Token pro Minute.
- Innerhalb der letzten Minute wurden 31.222 Token verbraucht.
- Damit stehen noch 8.778 Token zur Verfügung.
- Die Anfrage hätte 14.701 Token benötigt, was die verfügbare Token-Anzahl innerhalb des einminütigen Zeitfensters überstieg.
Tokenverbrauch – Grobe Schätzung (Mathematik)
Basislinie für natürliche Konversation
- Die Token-Nutzung hängt von verschiedenen Faktoren ab, darunter:
- Sprache
- verwendetes Modell
- Gesprächsstil
- Anzahl der gesprochenen Wörter
- Hier einige realistische Annahmen/Durchschnittswerte:
- Ein natürliches Gespräch umfasst normalerweise etwa 150 Wörter pro Minute.
- Jeder Anruf dauert maximal 7 Minuten.
- Das bedeutet, dass ein 7-minütiges Gespräch etwa 1.050 Wörter umfasst.
- Das allgemein akzeptierte Token-Umrechnungsverhältnis von OpenAI (für Englisch) beträgt 1 Wort = 1,3 Token.
- Ein 7-minütiges Gespräch würde somit 1.365 Token verbrauchen.
Wir können davon ausgehen, dass eine natürliche Konversation typischerweise maximal 1.500 Token umfasst.
Anpassungen je nach Art und Komplexität des Anrufs
- Wenn der Anrufer sich lediglich meldet oder einen Termin vereinbart, muss der KI-Agent kaum nachdenken.
- Eine konservative Schätzung geht von maximal 1.000 Tokens pro Anruf aus.
- Handelt es sich um ein ausgewogenes Gespräch über die Arbeit, die Durchsicht eines Dokuments oder einen allgemeinen Chat
- so entspricht dies der Schätzung für ein „natürliches Gespräch“ mit maximal 1.500 Tokens.
- Ist der Anruf hingegen komplex und technisch, muss der KI-Agent mehr „nachdenken“:
- Hier kann man mit maximal 2.500 Tokens pro Anruf rechnen.
KI-Agenten nutzen Wissensquellen
Wenn Sie Wissensquellen mit Ihren KI-Agenten verwenden, sollten Sie auch einen Token-Overhead für den Abruf der Wissensquellen einkalkulieren; schätzen Sie die zusätzlichen Abrufkosten auf bis zu 2.000 Token.
Gesamte Token-Nutzungsschätzung
Auf Grundlage der obigen Annahmen und Schätzungen lässt sich schlussfolgern, dass ein technischer KI-Aufruf mit Wissensquellen Folgendes verbrauchen würde:
- 2.500 Token für den Anruf
- 2.000 Token für den Abruf der Wissensquellen
Bei einem Sicherheitspuffer von 500 Tokens würde Ihr Anruf 5.000 Tokens verbrauchen, also 714 Tokens pro Minute. Sie können diesen Wert auf 1.000 Tokens pro Minute aufrunden.
Wie viele Anrufe kann der KI-Agent bearbeiten?
Sie müssen zwei Vorgaben erfüllen:
- Tokens pro Minute
- Anfragen pro Minute
Token pro Minute
Wenn Sie die Ratenbegrenzung Ihres KI-Modells auf 20.000 Token pro Minute konfiguriert haben, kann der KI-Agent bei 1.000 TPM pro Anruf 20 gleichzeitige Anrufe bearbeiten.
Anfragen pro Minute
Wir gehen hier nicht ins Detail, aber bedenken Sie, dass jeder KI-Aufruf mehrere Anfragen pro Minute generieren kann. Wenn Sie Ihr System beispielsweise für 50 gleichzeitige KI-Aufrufe konfigurieren und die Anruftypen, die Sie typischerweise erhalten, 3 Anfragen pro Minute generieren, sollten Sie logischerweise auch Ihre RPM auf mindestens 150 einstellen.
Navigation durch die OpenAI-Nutzungsstufen und Ratenbegrenzungen
Die meisten Nutzer beginnen standardmäßig im kostenlosen Tarif – daher ist es verständlich, dass Sie an die Ratenbegrenzungen stoßen können. OpenAI-Konten, die mindestens 100 US-Dollar zahlen, werden in der Regel direkt in die Stufe 3 hochgestuft.
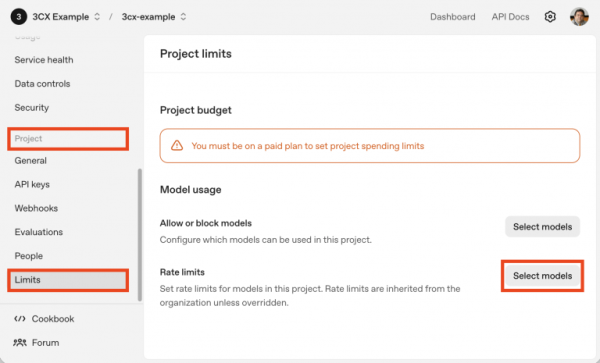
Navigieren Sie auf der OpenAI-Plattform zu Ihrem Projekt-Dashboard und gehen Sie zur Seite Projekt -> Limits; klicken Sie unter der Überschrift “Ratenbegrenzungen” auf die Schaltfläche “Modelle auswählen”.
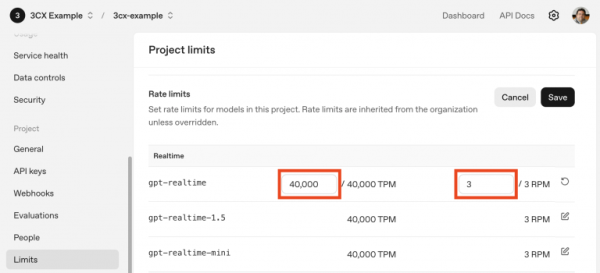
Scrollen Sie nach unten zu den Echtzeit-Ratenbegrenzungen. Dort können Sie Ihre Ratenbegrenzungen anpassen. Dabei gilt:
- TPM ist Ihre maximale Anzahl an Token pro Minute.
- RPM ist Ihre maximale Anzahl an Anfragen pro Minute.
Der obige Screenshot zeigt ein Konto im kostenlosen Tarif. Sie sehen, dass maximal 40.000 TPM und 3 RPM zulässig sind. Navigieren Sie zu „Organisation“ → „Limits“ und passen Sie Ihr Budget an, um in einen höheren Tarif zu wechseln.
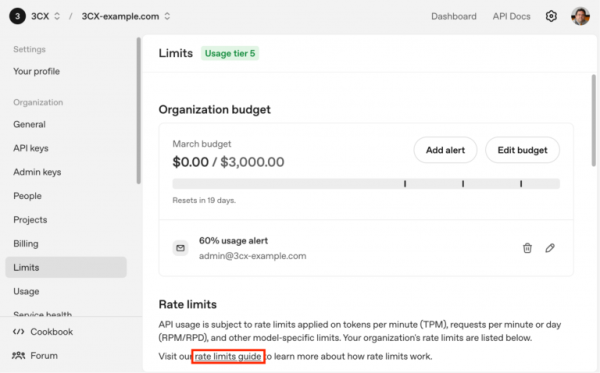
Für weitere Details klicken Sie auf den Link zum Leitfaden für Ratenbegrenzungen; hier ist die Haupttabelle der Nutzungsstufen:
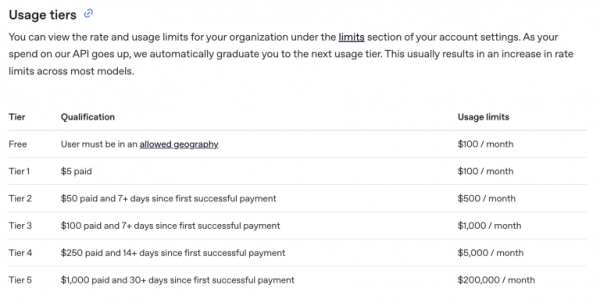
Sobald Sie die erforderlichen Schwellenwerte erreicht haben, wird Ihr Tarif automatisch angepasst. Gehen Sie erneut zu Ihrem Projekt -> Limits, um Ihre Limits bei Bedarf zu erhöhen.
Forum
Setzen Sie die Diskussion in unserem KI-Forum fort. Folgen Sie uns auf X und LinkedIn, um über aktuelle Neuigkeiten und neue Funktionen informiert zu bleiben.

 Copyright © 2025